配 AI 服务器实测|百 万内单机算力猛兽,DeepSeek-V4 推理吞吐突破 2000+tok/s
1TB 内存 + 8 张 Blackwell旗舰显卡,单机挑战当下最火的大模型,全程零报错。
一次"把大模型跑起来"的实测
大家好,今天不聊高深的理论,只分享一次"开箱即用"式的实测体验。
我们手头有一台"猛兽级"服务器:128 个逻辑线程、1TB 内存、8 张顶配专业显卡。这一次,我们把当下最火的开源大模型之一 DeepSeek-V4 跑在上面,做了一次完整的压力测试。
到底快不快?人多的时候扛不扛得住?长文章读得动吗?看完这篇文章,你就全明白了。
一、先认识一下这台"猛兽"
别急着看数据,我们先用大白话认识一下这台机器。你可以把它想象成一支"特种部队":
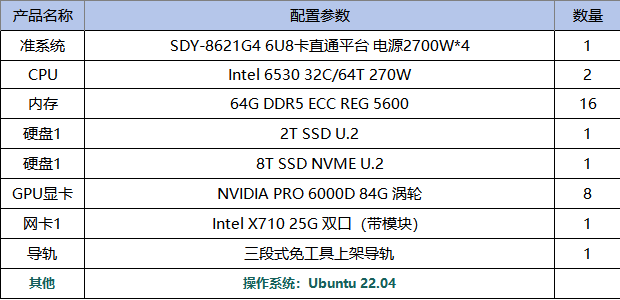
CPU(大脑):6530*2=128 个"线程",相当于 128 个工人同时干活,人多力量大;
内存(工作台):64G*16=1TB,约等于 250 部高清电影同时"摆"在桌上,随时取用;
显卡(最强大脑):8 张 NVIDIA RTX 6000D,合计显存约 685GiB,是大模型推理的绝对主力;
系统盘(仓库):2TB 企业级 NVMe 固态,读写快得飞起;
网络(交通):目前是千兆(1Gbps),日常够用,但算得上这台机器的一个"小短板"。
一句话总结:这台机器,就是为"单机跑大模型"而生的。二、性能摸底:到底能打几分?
正式"考试"之前,先做一次全面摸底,科目包括 CPU、内存、磁盘、网络和显卡。
2.1 CPU 与内存:人多力量大,碗大装得多
CPU 从 1 个线程加到 128 个线程,计算能力一路飙升,满载时比单线程强了 17 倍。日常做数据预处理、模型量化,都是小菜一碟。
内存更是夸张:读写带宽实测在 400GB/s 以上——什么概念?相当于每秒能"读"完几十部高清电影。1TB 的容量,让你加载大模型时完全不用抠抠搜搜。
2.2 磁盘与网络:一个"优等生",一个"偏科生"
系统盘是 2TB 企业级 NVMe 固态,顺序读取 3.38GB/s、4K 随机读取 42.8 万 IOPS,属于企业级正常水平。唯一要留意的:可用空间剩 303GB 左右,装大模型时得精打细算。
网络就"偏科"了。网卡硬件支持万兆,但当前物理链路协商在千兆,实测跑满约 930Mbps。日常管理够用,可真要搞多机分布式训练、批量分发模型,它就会成为瓶颈——这也是可以升级的地方。
2.3 显卡:真正的"王炸"
8 张 Blackwell 架构专业卡,每张显存带宽实测约 1278GB/s、FP16 算力峰值约 234 TFLOPS。8 卡合计约 685GiB 显存,大模型的权重 + 缓存都能轻松装下,还启用了 ECC 纠错,跑起来相当省心。
三、正式"考试":DeepSeek-V4 压测实录
硬件摸完底,主角登场。我们跑的是 DeepSeek-V4 的 FP8 量化版,8 张卡并行工作,模拟真实使用场景做压力测试。
3.1 单用户体验:基本是"秒回"
一个人用的时候,它有多快?
生成速度:约 85–90 字/秒,平均每个字只要 11 毫秒; 首字响应:约 0.1 秒,你刚敲完回车,文字就开始"蹦"出来了。
日常聊天、写代码、写文章,体感就一个字:爽。
3.2 多人大并发:从 1 个人到 64 个人,不慌
真实场景下不可能只有一个用户。我们一路从 1 个并发加到 64 个并发:
1 个并发:90 字/秒; 16 个并发:约 909 字/秒; 64 个并发:直接飙到 2020 字/秒!
更难得的是,吞吐几乎随着并发数线性增长,全程零报错——说明这台机器的算力被利用得非常充分。
3.3 持续高负载:连跑 60 秒,稳不稳?
光看短时间还不够,我们还做了持续压力测试:64 个并发持续轰炸 60 秒,聚合吞吐冲到 2184.5 字/秒,显卡利用率峰值 100%、平均 98% 以上,依然零错误。散热也压得住,最高温度 73°C,属于很安全的范围。
3.4 长文本:读得下"大部头"
大模型除了快,还得"读"得动长内容。我们测试了最长 256K tokens 的输入——差不多相当于几十万字的体量,预填充只需要 9.7 秒,上下文窗口最高更是支持 1M。写长篇小说、总结几十万字的报告,都不是问题。
3.5 日常功能:一个不少
基本对话、思维链(让模型"先想后答")、工具调用(比如让它帮你查天气)全部正常。功能层面,没有短板。
四、客观聊聊:长板与短板
长板(强的地方):
单机一体化,省去集群高额搭建成本
一百万内整机即可实现小型集群算力,不用采购多台服务器、交换机、高速互联设备,省去机房布线、多机调度运维人力,中小企业、高校实验室低成本落地私有大模型; 算力覆盖全链路 AI 业务 685GiB 显存 + 1TB 内存双重超大缓存:既能完成 70B 参数模型训练 / 微调,也能流畅跑 600B 超大模型 FP8 量化推理,一套机器覆盖模型研发、训练、上线服务全流程; 高并发稳定承载,可直接投产商用 64 并发 2000+tok/s 线性吞吐、长时间满载零故障,可直接搭建企业内部 AI 中台、客服机器人、文档知识库、代码助手,支撑数十人同时在线商用 硬件容错可靠,适配长期生产部署 显卡搭载 ECC 纠错显存,高温负载稳定控温,企业生产环境、实验室长期不间断运行,降低硬件故障带来业务中断风险。
短板(需要留意的地方):
网络只有千兆,多机扩展受限;
卡间没有 NVLink 高速互联,大规模并行训练时通信偏慢;
磁盘剩 303GB,大模型得搭配更大的。
五、落地适配人群与总结
这台总价 一百 万左右的 8 卡 RTX 6000D AI 服务器,是兼顾性能与落地成本的单机算力标杆,精准适配三类用户:
高校、科研实验室:用于大模型微调、算法研发、长文本科研分析
中大型企业:私有化部署专属 AI 中台,内部员工、业务线高并发调用,数据不出内网保障安全
AI 技术服务商:单机搭建私有推理服务,对外提供稳定大模型 API 能力。
实测证明:单台设备即可释放 2000+tok/s 超高推理吞吐,兼顾训练、微调、商用推理全场景,相比搭建多机集群大幅降低采购与运维成本,82 万整机投入即可拥有一套可直接投产的私有化完整 AI 算力底座
如果你也在折腾大模型,对服务器有需求,欢迎在评论区聊聊你的配置和玩法;有服务器需求的,扫描网页底部二维码,联系工程师可免费咨询服务器产品配置及报价方案。
本文数据基于 Ubuntu 22.04.5、NVIDIA 580.95.05 驱动、CUDA 13.0 环境下的实测结果,仅供参考。